4
0
0
GPT2的Pytorch实现
2026-10-04
2026-10-04
文章摘要
|
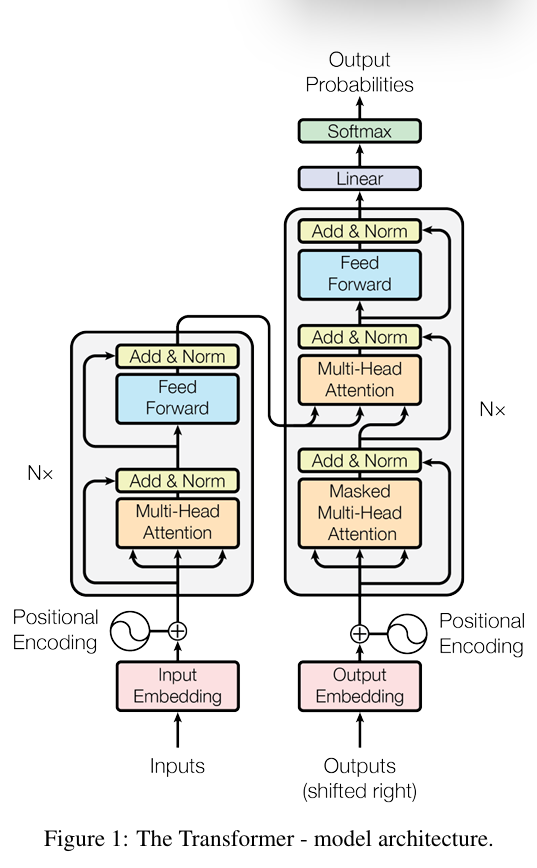
一、Transformer架构
万恶之源:Attention Is All You Need
1.解码端
(1)词元转化为嵌入向量
初看架构图,很容易产生一进二出的错觉。但实际上,这是一个双输入、单输出的自回归系统。
先讨论编码块,我们最初将词元进行分割,然后加入相关的位置信息,输入到Transformer块中。
从线性代数的角度去想,我输入了一个词,这个词有N个特征,所以说他应该是一个1XN的一个嵌入向量被输入进去(CPU串行角度)
实际上是Batch × Seq × N,他实际上会输入Batch 句话,每句话有Seq个词元,每个词元 有N个特征(并行角度)
简洁的来说,他看到(输入)是一整句话(上下文),但是他的输出是一个字一个字出来的。
词元分割
随机初始化
self.embedding = nn.Embedding(vocab_size, d_model)位置信息嵌入
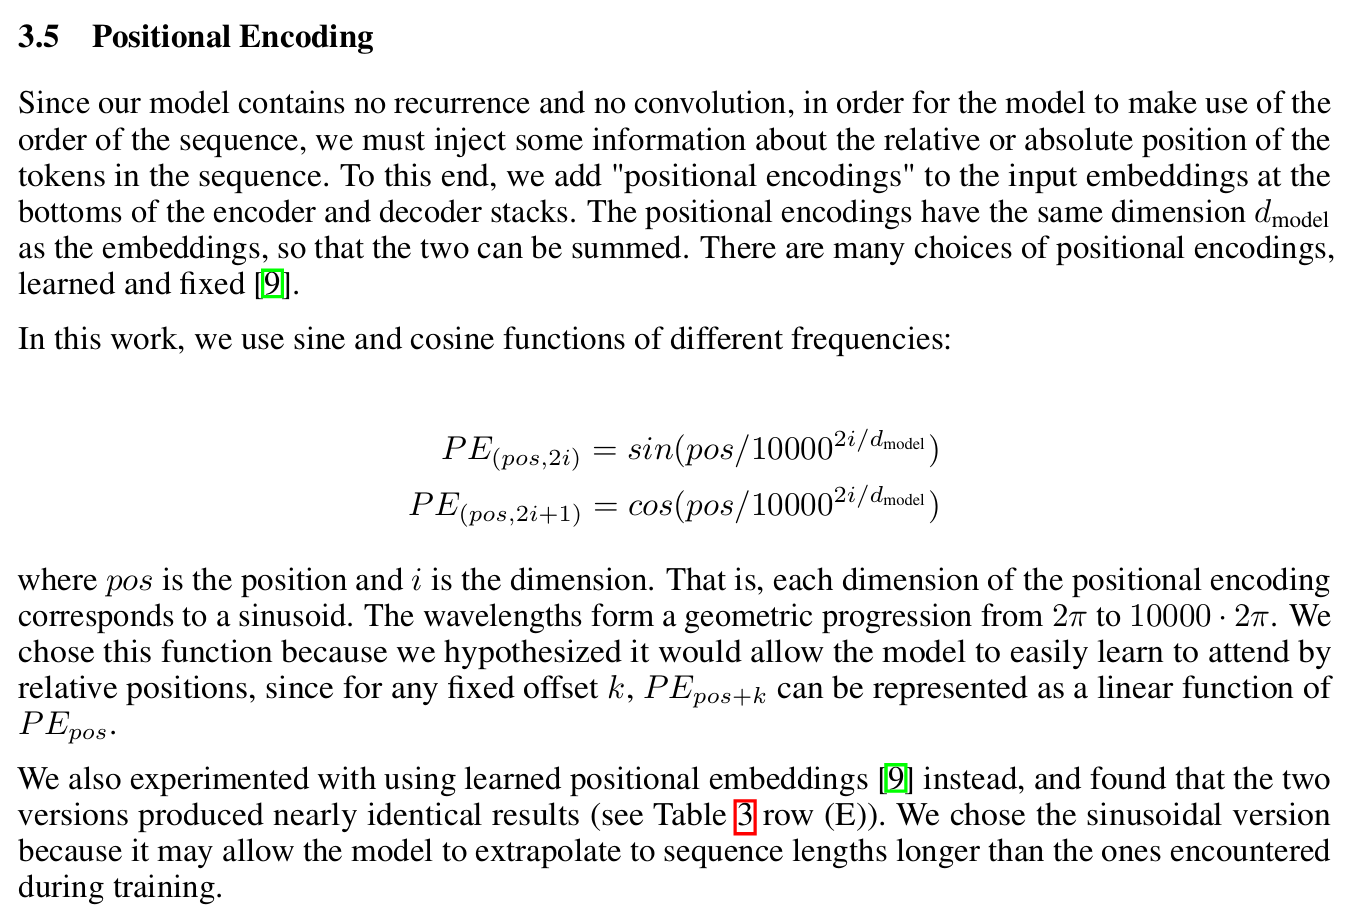
class PositionalEncoding(nn.Module):
    # d_model 一个词的特征值  Man_len 一句话最多能容纳多少个词(这里本质上是查表,所以说我只需要定义一个最大的值即可,其他的靠查询)
    def __init__(self, d_model, max_len=5000):
        super().__init__()
        pe = torch.zeros(max_len, d_model)
        #        (max_len, 1) (5000, 1)
        #    生成了 1个 1维张量(向量),里面存了5000个数。然后 .unsqueeze(1) 给它加了一个维度,把它变成了 2维张量(列向量)
        position = torch.arange(0, max_len, dtype=torch.float).unsqueeze(1)
        #        (256,)  -----> (1,256)
        div_term = torch.exp(torch.arange(0, d_model, 2) * -(math.log(10000.0) / d_model))
        pe[:, 0::2] = torch.sin(position * div_term)
        pe[:, 1::2] = torch.cos(position * div_term)
        pe = pe.unsqueeze(0)
        #只读的常量
        self.register_buffer('pe', pe)

    def forward(self, x):
        seq_len = x.size(1)
        x = x + self.pe[:, :seq_len, :]
        return x
(2)多头注意力机制
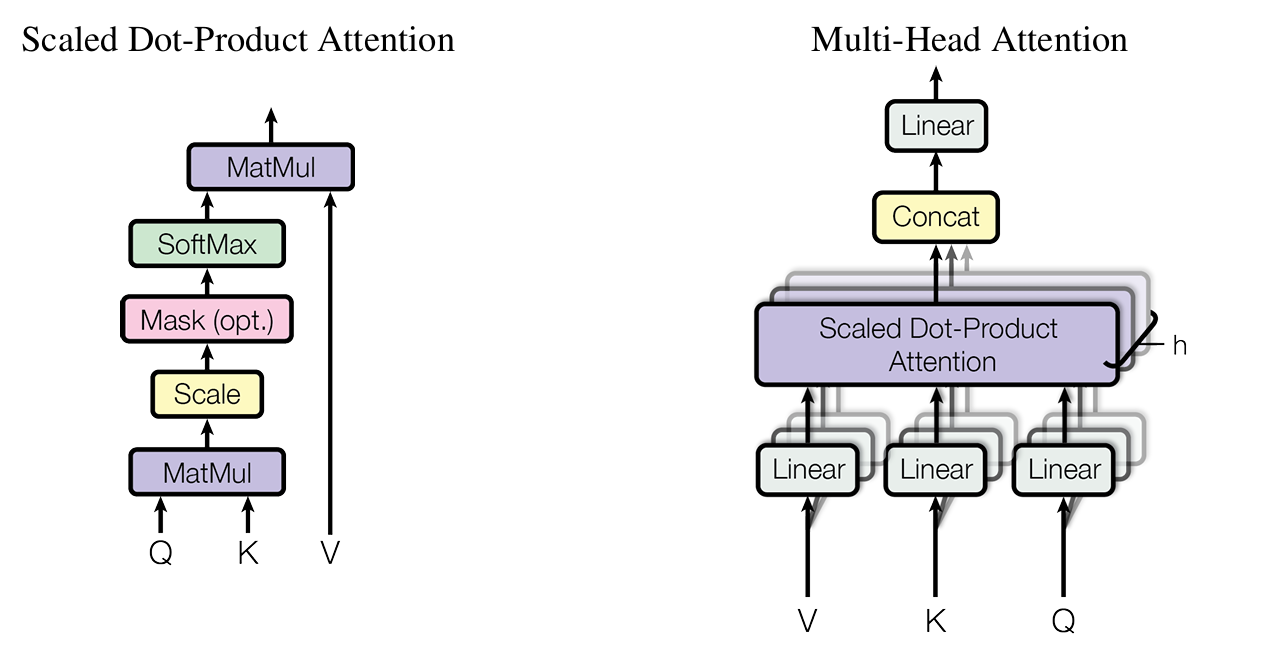
缩放点积注意力核心公式如下:
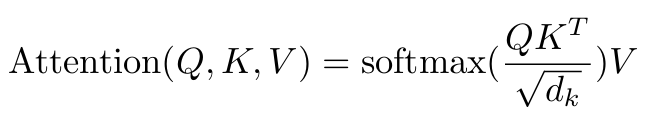
class MultiHeadAttention(nn.Module):
    def __init__(self, d_model, n_heads, dropout=0.1):
        # d_model 一个词的特征值  n_head头数
        super().__init__()
        assert d_model % n_heads == 0, "d_model必须能被n_heads整除"
        self.d_k = d_model // n_heads  # 每个头的维度: 512/8 = 64
        self.n_heads = n_heads          # 头数: 8

        # nn.Linear(in_features, out_features): 全连接层 y = xW^T + b
        # 这里 in=out=d_model,即 512→512,但权重矩阵会学到有用的变换
        self.W_q = nn.Linear(d_model, d_model)  # Q 的线性变换
        self.W_k = nn.Linear(d_model, d_model)  # K 的线性变换
        self.W_v = nn.Linear(d_model, d_model)  # V 的线性变换
        self.fc  = nn.Linear(d_model, d_model)   # 多头拼接后的输出映射

        self.attention = SelfAttention(dropout)
        self.dropout = nn.Dropout(dropout)
        self.norm = nn.LayerNorm(d_model)


    def forward(self, q, k, v, mask=None):
        """
        参数:
            q: (batch, seq_len, d_model)  查询输入
            k: (batch, seq_len, d_model)  键输入
            v: (batch, seq_len, d_model)  值输入
            mask: 可广播的mask张量
        注意: 在自注意力中 q=k=v=同一个输入;在交叉注意力中 q来自解码器, k=v来自编码器
        """
        batch_size = q.size(0)


        # (batch, 8, seq_len, 64)
        Q = self.W_q(q).view(batch_size, -1, self.n_heads, self.d_k).transpose(1, 2)
        K = self.W_k(k).view(batch_size, -1, self.n_heads, self.d_k).transpose(1, 2)
        V = self.W_v(v).view(batch_size, -1, self.n_heads, self.d_k).transpose(1, 2)
        # 现在 Q/K/V 形状都是 (batch, n_heads, seq_len, d_k) = (32, 8, 20, 64)


        # 所有头并行计算,不需要循环,因为 batch 维度会自动处理
        # out: (batch, 8, seq_len, 64)  attn: (batch, 8, seq_len, seq_len)
        out, attn = self.attention(Q, K, V, mask)

        # .transpose(1, 2): (batch, 8, seq_len, 64) → (batch, seq_len, 8, 64)
        # .contiguous(): 确保内存连续(transpose后内存不连续,view需要连续内存)
        # .view(batch_size, -1, self.n_heads * self.d_k): → (batch, seq_len, 512)
        #   把 8×64 拼回 512,这就完成了"多头拼接"
        out = out.transpose(1, 2).contiguous().view(batch_size, -1, self.n_heads * self.d_k)

        out = self.fc(out)      # (batch, seq_len, 512) → (batch, seq_len, 512)
        out = self.dropout(out)

        # 残差连接: out + q
        out = self.norm(out + q)
        return out, attn
class SelfAttention(nn.Module):
    def __init__(self, dropout=0.1):
        super().__init__()
        self.dropout = nn.Dropout(dropout)
        self.softmax = nn.Softmax(dim=-1)

    def forward(self, Q, K, V, mask=None):
        """
        参数:
            Q: (batch, heads, seq_len_q, d_k)  查询矩阵
            K: (batch, heads, seq_len_k, d_k)  键矩阵
            V: (batch, heads, seq_len_k, d_v)  值矩阵 (d_v 通常等于 d_k)
            mask: (seq_len_q, seq_len_k) 或可广播的形状
        返回:
            out: (batch, heads, seq_len_q, d_v)  注意力输出
            attn: (batch, heads, seq_len_q, seq_len_k)  注意力权重
        """
        d_k = Q.size(-1)  # 获取每个头的维度 d_k = d_model / n_heads = 512/8 = 64

        #   Q: (batch, heads, d_k, seq_len_q)  查询矩阵
        scores = torch.matmul(Q, K.transpose(-2, -1)) / math.sqrt(d_k)
        if mask is not None:
            scores = scores.masked_fill(mask == 0, float('-inf'))
        attn = self.softmax(scores)
        attn = self.dropout(attn)
        out = torch.matmul(attn, V)
        return out, attn
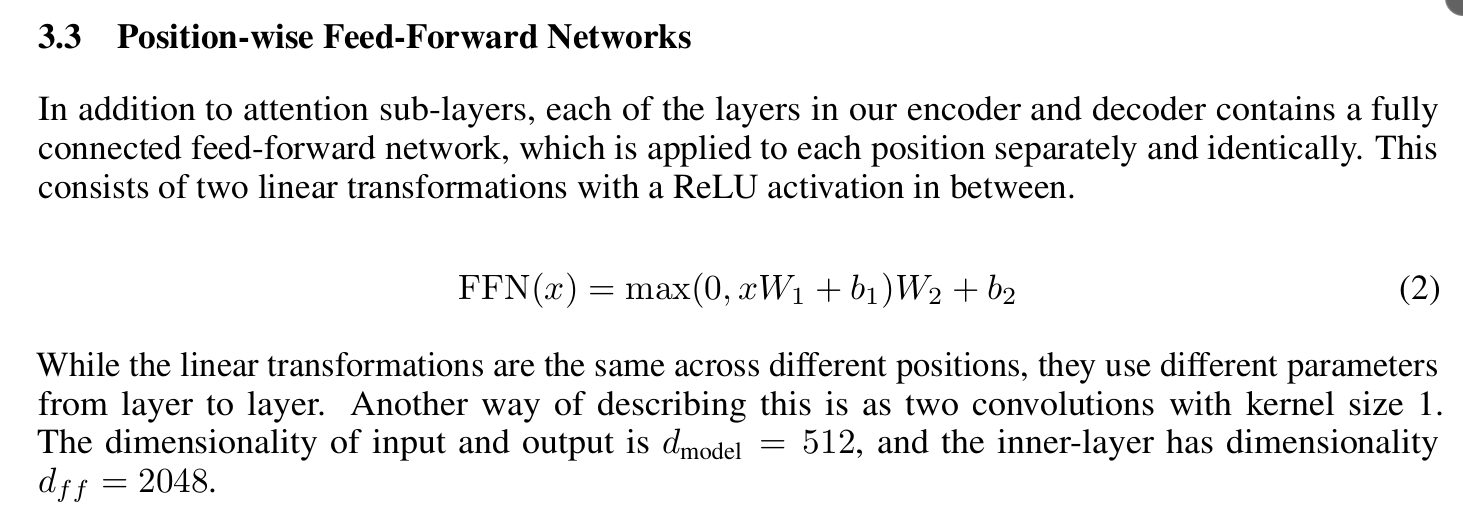
这一部分的代码实现是这样的,利用Pytorch中的liner函数(全连接层),让传入的(Batch, Seq, N)矩阵进入这个函数中,吐出来一个新函数,是走了前向传播的基本单元(线性),转换出了Query (查询)、Key (键) 和 Value (值),下面的分母防止梯度爆炸,防止出现学习效果下降等问题。Q 是主动去“问”的。K 是被用来“匹配”的。V 是匹配成功后真正要“拿走”的内容。然后讲VKQ送入缩放点积注意力中,最后再做一遍Linear。到这里就要做一下残差相加与归一化。最后送入前馈网络,如下:
(3)前馈网络机制
class FeedForward(nn.Module):
    def __init__(self,d_module,d_ff,dropout=0.1):
        super().__init__()
        self.fc1 = nn.Linear(d_module, d_ff) #第一层全连接层 512---->2048
        self.fc2 = nn.Linear(d_ff, d_module) #第二层全连接层
        self.dropout = nn.Dropout(dropout) #对10%做失活 防止过拟合
        self.norm = nn.LayerNorm(d_module) #用于残差后的归一化

    def forward(self,x):
        out = self.fc2(self.dropout(torch.relu(self.fc1(x))))
return self.norm(out+x) #残差链接+归一化公式中做了一次全连接层,然后做了Relu激活,之后又做了一次全连接。最后与残差相加后做归一化,输出至交叉注意力中(Encoder 的输出确实进入了交叉注意力,但它不是直接“流”进去的,而是作为“记忆”被存储起来供 Decoder 调用的)。
最后编码层如下:
class EncoderLayer(nn.Module):
    def __init__(self, d_model, n_heads, d_ff, dropout=0.1):
        super().__init__()
        self.self_attn = MultiHeadAttention(d_model, n_heads, dropout)
        self.feed_forward = FeedForward(d_model, d_ff, dropout)

    def forward(self, x, mask=None):
        # 自注意力: Q=K=V=x,所以叫"自"注意力——每个位置都能关注所有位置
        # 在编码器中 mask 通常是 None 或 padding mask
        # 编码器不需要因果mask(不需要防止看到未来),因为编码器看的是完整的输入
        out, _ = self.self_attn(x, x, x, mask)  # _ 是注意力权重,这里不用
        out = self.feed_forward(out)
        return out
整个Transformer架构如下:
class Encoder(nn.Module):
    def __init__(self, vocab_size, d_model, n_heads, num_layer, d_ff, dropout=0.1, max_len=5000):
        super().__init__()
        # nn.Embedding(num_embeddings, embedding_dim): 词嵌入层
        self.embedding = nn.Embedding(vocab_size, d_model)
        #位置编码
        self.positional_encoding = PositionalEncoding(d_model, max_len)
        self.layers = nn.ModuleList([
            EncoderLayer(d_model, n_heads, d_ff, dropout) for _ in range(num_layer)
        ])


    def forward(self, x, mask=None):
        """
        参数:
            x: (batch, src_len) - 源序列的词ID
            mask: padding mask(可选,遮盖padding位置)
        返回:
            (batch, src_len, d_model) - 编码器输出
        """
        # 词嵌入 × √d_model + 位置编码
        out = self.embedding(x) * math.sqrt(self.embedding.embedding_dim)
        out = self.positional_encoding(out)

        # 逐层通过编码器
        for layer in self.layers:
            out = layer(out, mask)
        return out
2.解码层
class DecoderLayer(nn.Module):
    def __init__(self, d_model, n_heads, d_ff, dropout=0.1):
        super().__init__()
        self.self_attn = MultiHeadAttention(d_model, n_heads, dropout)   # 带因果mask的自注意力
        self.cross_attn = MultiHeadAttention(d_model, n_heads, dropout)  # 交叉注意力
        self.feed_forward = FeedForward(d_model, d_ff, dropout)

    def forward(self, x, enc_out, src_mask=None, tgt_mask=None):
        """
        参数:
            x: (batch, tgt_len, d_model)    解码器输入
            enc_out: (batch, src_len, d_model)  编码器输出
            src_mask: 源序列的padding mask(用于交叉注意力,遮盖padding位置)
            tgt_mask: 因果mask(用于自注意力,防止看到未来)
        """
        # 第1步: 带因果mask的自注意力
        out, _ = self.self_attn(x, x, x, tgt_mask)

        # 第2步: 交叉注意力 (Cross-Attention)
        out, _ = self.cross_attn(out, enc_out, enc_out, src_mask)

        # 第3步: 前馈网络
        out = self.feed_forward(out)
        return out
class Decoder(nn.Module):
    def __init__(self, vocab_size, d_model, n_heads, num_layer, d_ff, dropout=0.1, max_len=5000):
        super().__init__()
        self.embedding = nn.Embedding(vocab_size, d_model)
        self.positional_encoding = PositionalEncoding(d_model, max_len)
        self.layers = nn.ModuleList([
            DecoderLayer(d_model, n_heads, d_ff, dropout) for _ in range(num_layer)
        ])
        self.fc_out = nn.Linear(d_model, vocab_size)
        # 最终输出层: 512维 → 词表大小(如10000)
        # 输出 logits(未归一化的分数),训练时配合 CrossEntropyLoss 使用

    def forward(self, x, enc_out, src_mask=None, tgt_mask=None):
        """
        参数:
            x: (batch, tgt_len) - 目标序列的词ID
            enc_out: (batch, src_len, d_model) - 编码器输出
            src_mask: 源序列padding mask
            tgt_mask: 因果mask (tgt_len, tgt_len)
        返回:
            (batch, tgt_len, vocab_size) - 每个位置的词概率分布(logits)
        """
        out = self.embedding(x) * math.sqrt(self.embedding.embedding_dim)
        out = self.positional_encoding(out)

        for layer in self.layers:
            # 每个解码器层都接收编码器输出 enc_out,用于交叉注意力
            out = layer(out, enc_out, src_mask, tgt_mask)

        out = self.fc_out(out)  # 映射到词表维度
        return out
最后 :
class Transformer(nn.Module):
    def __init__(self, src_vocab_size, tgt_vocab_size, d_model=512, n_heads=8,
                 num_layer=6, d_ff=2048, dropout=0.1, max_len=5000):
        super().__init__()
        self.encoder = Encoder(src_vocab_size, d_model, n_heads, num_layer, d_ff, dropout, max_len)
        self.decoder = Decoder(tgt_vocab_size, d_model, n_heads, num_layer, d_ff, dropout, max_len)

    def forward(self, src_seq, tgt_seq, src_mask=None, tgt_mask=None):
        """
        参数:
            src_seq: (batch, src_len) 源序列词ID
            tgt_seq: (batch, tgt_len) 目标序列词ID
            src_mask: 源序列mask(遮盖padding)
            tgt_mask: 目标序列因果mask(防止看到未来)
        返回:
            (batch, tgt_len, tgt_vocab_size) logits
        """
        enc_out = self.encoder(src_seq, src_mask)       # 编码: (B, src_len, 512)
        dec_out = self.decoder(tgt_seq, enc_out, src_mask, tgt_mask)  # 解码: (B, tgt_len, vocab_size)
        return dec_out
未完待续